 AMD, Taalas'ı satın alarak yapay zeka ağırlıklarını çipe entegre ediyorAMD integrates AI weights onto the chip by acquiring TaalasHabere gitRead the article Türkçe (otomatik çeviri) English (automatic translation) |
ÖzetSummaryAMD, yapay zeka model ağırlıklarını doğrudan özel çiplere yerleştirerek çıkarım gecikmesini, güç tüketimini ve donanım maliyetini düşüren Kanada merkezli Taalas'ı satın almak için nihai anlaşmayı imzaladı. Anlaşma, düzenleyici onay bekliyor ve AMD'nin Instinct GPU, EPYC ve ROCm yığınına entegre edilecek.AMD has signed a definitive agreement to acquire Taalas, a Canada-based company that embeds AI model weights directly into custom chips to reduce inference latency, power consumption, and hardware costs. The deal is pending regulatory approval and will be integrated into AMD's Instinct GPU, EPYC, and ROCm stack. |
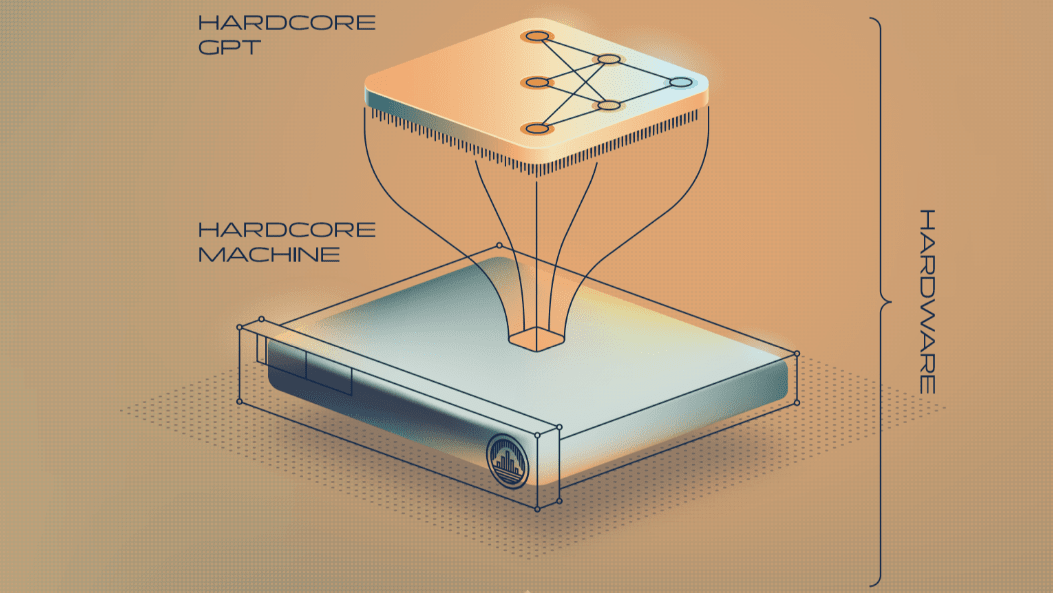
Neden ÖnemliWhy it mattersYapay zeka hesaplama harcamalarının büyük bölümü eğitimde değil, çıkarım aşamasında yapılıyor. Ağırlıkların HBM ile hesaplama die'si arasında taşınmasından kaynaklanan bellek bant genişliği darboğazı, birincil maliyet sürücüsü. Ağırlıkları çipin kendisine gömmek, bu darboğazı mimari düzeyde ele alıyor ve orta ölçekli modellerin büyük ölçekte sunulmasının ekonomisini yeniden şekillendirebilir. AMD için bu hamle, yapay zeka hikâyesini 'daha büyük GPU' anlayışının ötesine taşıyarak gerçekten farklı bir hesaplama paradigmine açılıyor.The majority of AI computing costs are incurred during inference rather than training. The memory bandwidth bottleneck caused by moving weights between HBM and the compute die is a primary cost driver. Embedding weights directly into the chip addresses this bottleneck at the architectural level and could reshape the economics of serving mid-sized models at scale. For AMD, this move elevates its AI narrative beyond the 'bigger GPU' mindset, opening the door to a genuinely different computing paradigm. |
Öne ÇıkanlarHighlights
|
EleştiriCritical takeTüm başlık performans ve maliyet verileri, tek bir 8B parametreli demo çipinde Taalas tarafından sağlanıyor; bağımsız kıyaslama veya üçüncü taraf doğrulaması yok. Birinci nesilde model kilitleme ödünleşimi ve kabul edilen niceleme kalite kaybı, 'GPU'nun yerini alan çözüm' iddiasının üretim gerçekliğinden hâlâ uzak olduğunu gösteriyor.All headline performance and cost data are provided by Taalas based on a single 8B parameter demo chip; there is no independent benchmarking or third-party verification. The model-locking trade-off in the first generation and the accepted quantization quality loss indicate that the claim of a 'GPU-replacing solution' remains distant from production reality. |