 Derin Sinir Ağlarının İç Algoritmalarını Açığa Çıkarma Yöntemi: Mekaniksel Yorumlama AnketiUnboxing the Black Box: A Survey on Mechanistic Interpretability for Algorithmic Understanding of Neural NetworksHabere gitRead the article Türkçe (otomatik çeviri) English (automatic translation) |
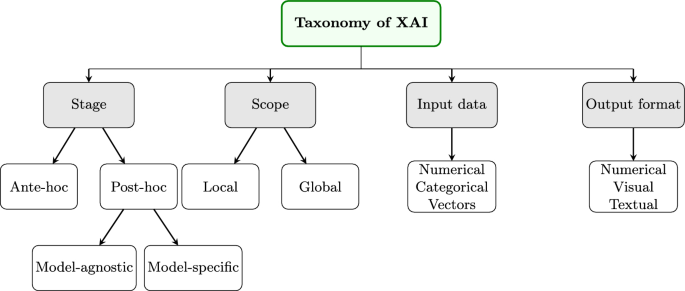
ÖzetSummaryBu makale, mekanistik yorumlanabilirlik (MI) üzerine kapsamlı bir inceleme sunarak birleşik bir taksonomi ve derin sinir ağlarının içsel algoritmalarını tersine mühendislik yoluyla ortaya çıkaran tekniklerin ayrıntılı analizini sağlıyor.This article provides a comprehensive review of mechanistic interpretability (MI), offering a unified taxonomy and detailed analysis of techniques that reverse-engineer the internal algorithms of deep neural networks. |
Neden ÖnemliWhy it mattersYapay zeka sistemleri giderek daha yaygın ve karmaşık hale geldikçe, içsel işleyişlerini anlamak şeffaf ve güvenilir modeller inşa etmek için hayati önem taşıyor. MI, daha geniş XAI alanı içinde sinirsel hesaplamaları insan tarafından anlaşılabilir algoritmalara dönüştürmeyi hedefleyerek öne çıkıyor ve makine öğrenmesi sistemlerine daha bilimsel bir kavrayış vaat ediyor.As AI systems become increasingly ubiquitous and complex, understanding their inner workings is crucial for building transparent and trustworthy models. MI stands out within the broader XAI field by aiming to translate neural computations into human-understandable algorithms, promising a more scientific grasp of machine learning systems. |
Öne ÇıkanlarHighlights
|
EleştiriCritical takeMI derin teorik içgörüler sunsa da, büyük ölçekli modellere ölçeklenebilirliği ve gerçek dünya uygulamalarında pratik dağıtımı hâlâ önemli zorluklar olarak karşımıza çıkıyor.While MI offers deep theoretical insights, scaling it to large models and deploying it practically in real-world applications remain significant challenges. |