 TypeSafe AI'ın Jev modeli halüsinasyonu sıfıra indiriyorTypeSafe AI’s Jev model reduces hallucinations to zeroHabere gitRead the article Türkçe (otomatik çeviri) English (automatic translation) |
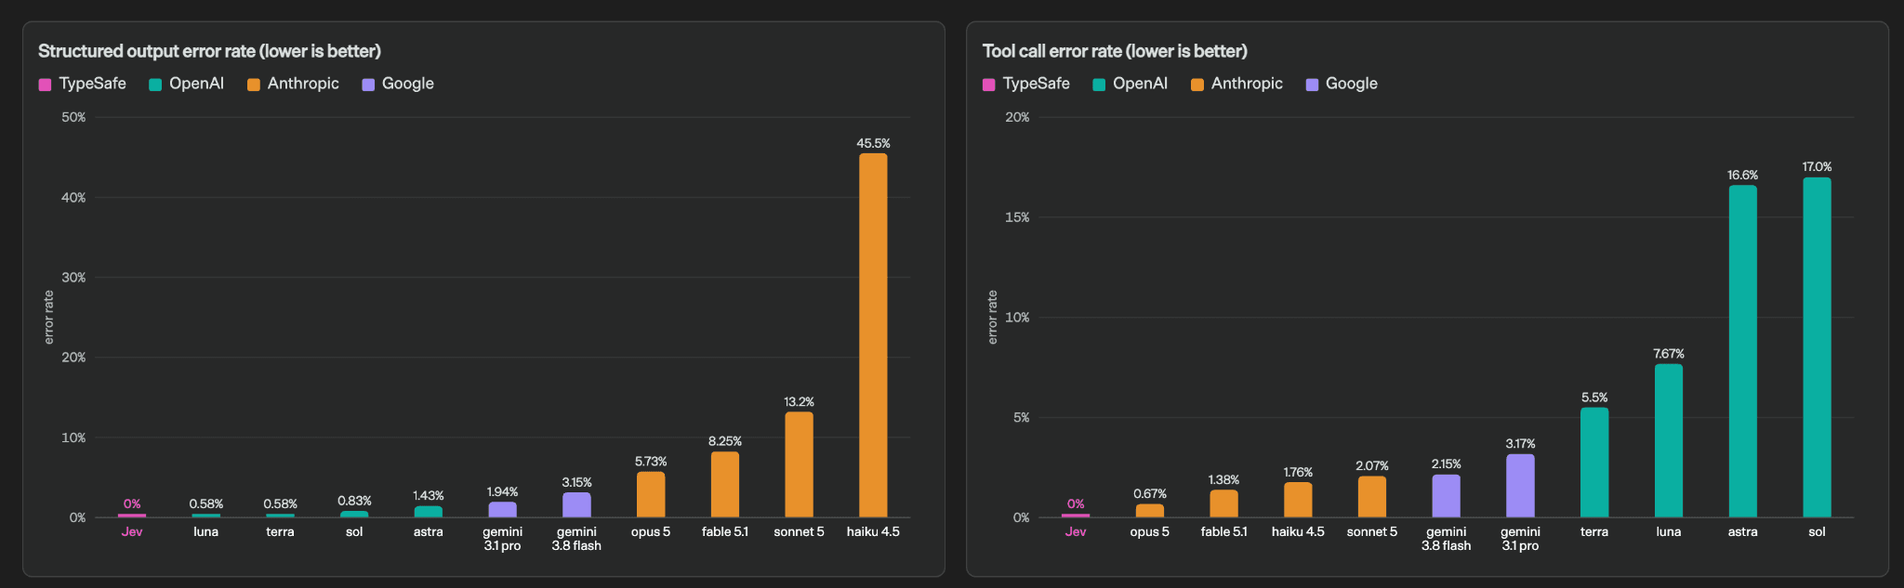
ÖzetSummaryTypeSafe AI, 'Jev' adlı modeli tanıttı. Model, belirsiz durumlarda tahmin yürütmek yerine 'bilmiyorum' yanıtını veren yeni bir RLCD (Kalibre Kararlar için Pekiştirmeli Öğrenme) tekniğine dayanıyor. Şirket, 100 bin soruluk bir kıyaslamada %0,042'lik neredeyse sıfıra yakın bir halüsinasyon oranı iddia ediyor; bu oran, tipik büyük dil modellerinde (LLM) %0,20 ile %10 arasında değişiyor.TypeSafe AI introduced a model called 'Jev'. The model relies on a new RLCD (Reinforcement Learning for Calibrated Decisions) technique, which opts to answer 'I don't know' in uncertain situations rather than making guesses. The company claims a near-zero hallucination rate of 0.042% in a 100,000-question benchmark; this rate is significantly lower than the 0.20% to 10% range typical of large language models (LLMs). |
Neden ÖnemliWhy it mattersHalüsinasyon, LLM'lerin düzenlemeye tabi, güvenlik açısından kritik veya müşteriyle doğrudan temas eden iş akışlarında devreye alınmasının önündeki en büyük güven engeli olmaya devam ediyor. Mevcut sistemlerin (GPT-6 Astra, Fable 5.1 vb.) üzerine bir kalibrasyon veya güvenlik katmanı olarak eklenebilecek bir model, şirketlerin doğrulama maliyetini ve sorumluluk riskini önemli ölçüde azaltabilir. 'Belirsizse yanıtı reddet' paradigması ölçeklenebilirse, sektörün odağı 'model ne kadar akıllı?' sorusundan 'model kendi sınırlarını ne kadar dürüstçe raporluyor?' sorusuna kayar.Hallucination remains the biggest trust barrier to deploying LLMs in regulated, safety-critical, or customer-facing workflows. A model that can be added as a calibration or safety layer on top of existing systems (such as GPT-6 Astra, Fable 5.1, etc.) could significantly reduce verification costs and liability risks for companies. If the 'refuse to answer when uncertain' paradigm scales, the industry's focus will shift from asking 'how smart is the model?' to 'how honestly does the model report its own limits?'. |
Öne ÇıkanlarHighlights
|
EleştiriCritical takeYazı açıkça 'Özel PR' etiketi taşıdığı için 'sıfır halüsinasyon' başlığı, hakemli kanıt değil, pazarlama metnidir. Zor soruları basitçe yanıtlamayı reddeden bir model, pratik fayda sunmadan düşük bir hata oranı elde edebilir. Ayrıca makale, kıyaslamada 'halüsinasyon'un nasıl ölçüldüğünü tanımlamadığı için %0,042'lik rakamın bağımsız olarak doğrulanması veya %0,20–%10 aralığındaki referans değerlerle karşılaştırılması imkânsızdır.Since the article is explicitly labeled as 'Corporate PR', the 'zero hallucination' headline is marketing copy, not peer-reviewed evidence. A model that simply refuses to answer difficult questions can achieve a low error rate without providing practical utility. Furthermore, because the article does not define how 'hallucination' was measured in the benchmark, it is impossible to independently verify the 0.042% figure or compare it against the 0.20%–10% reference range. |