 CW-Net, otonom araç kararlarını insanlara açıklıyorCW-Net explains autonomous vehicle decisions to humansHabere gitRead the article Türkçe (otomatik çeviri) English (automatic translation) |
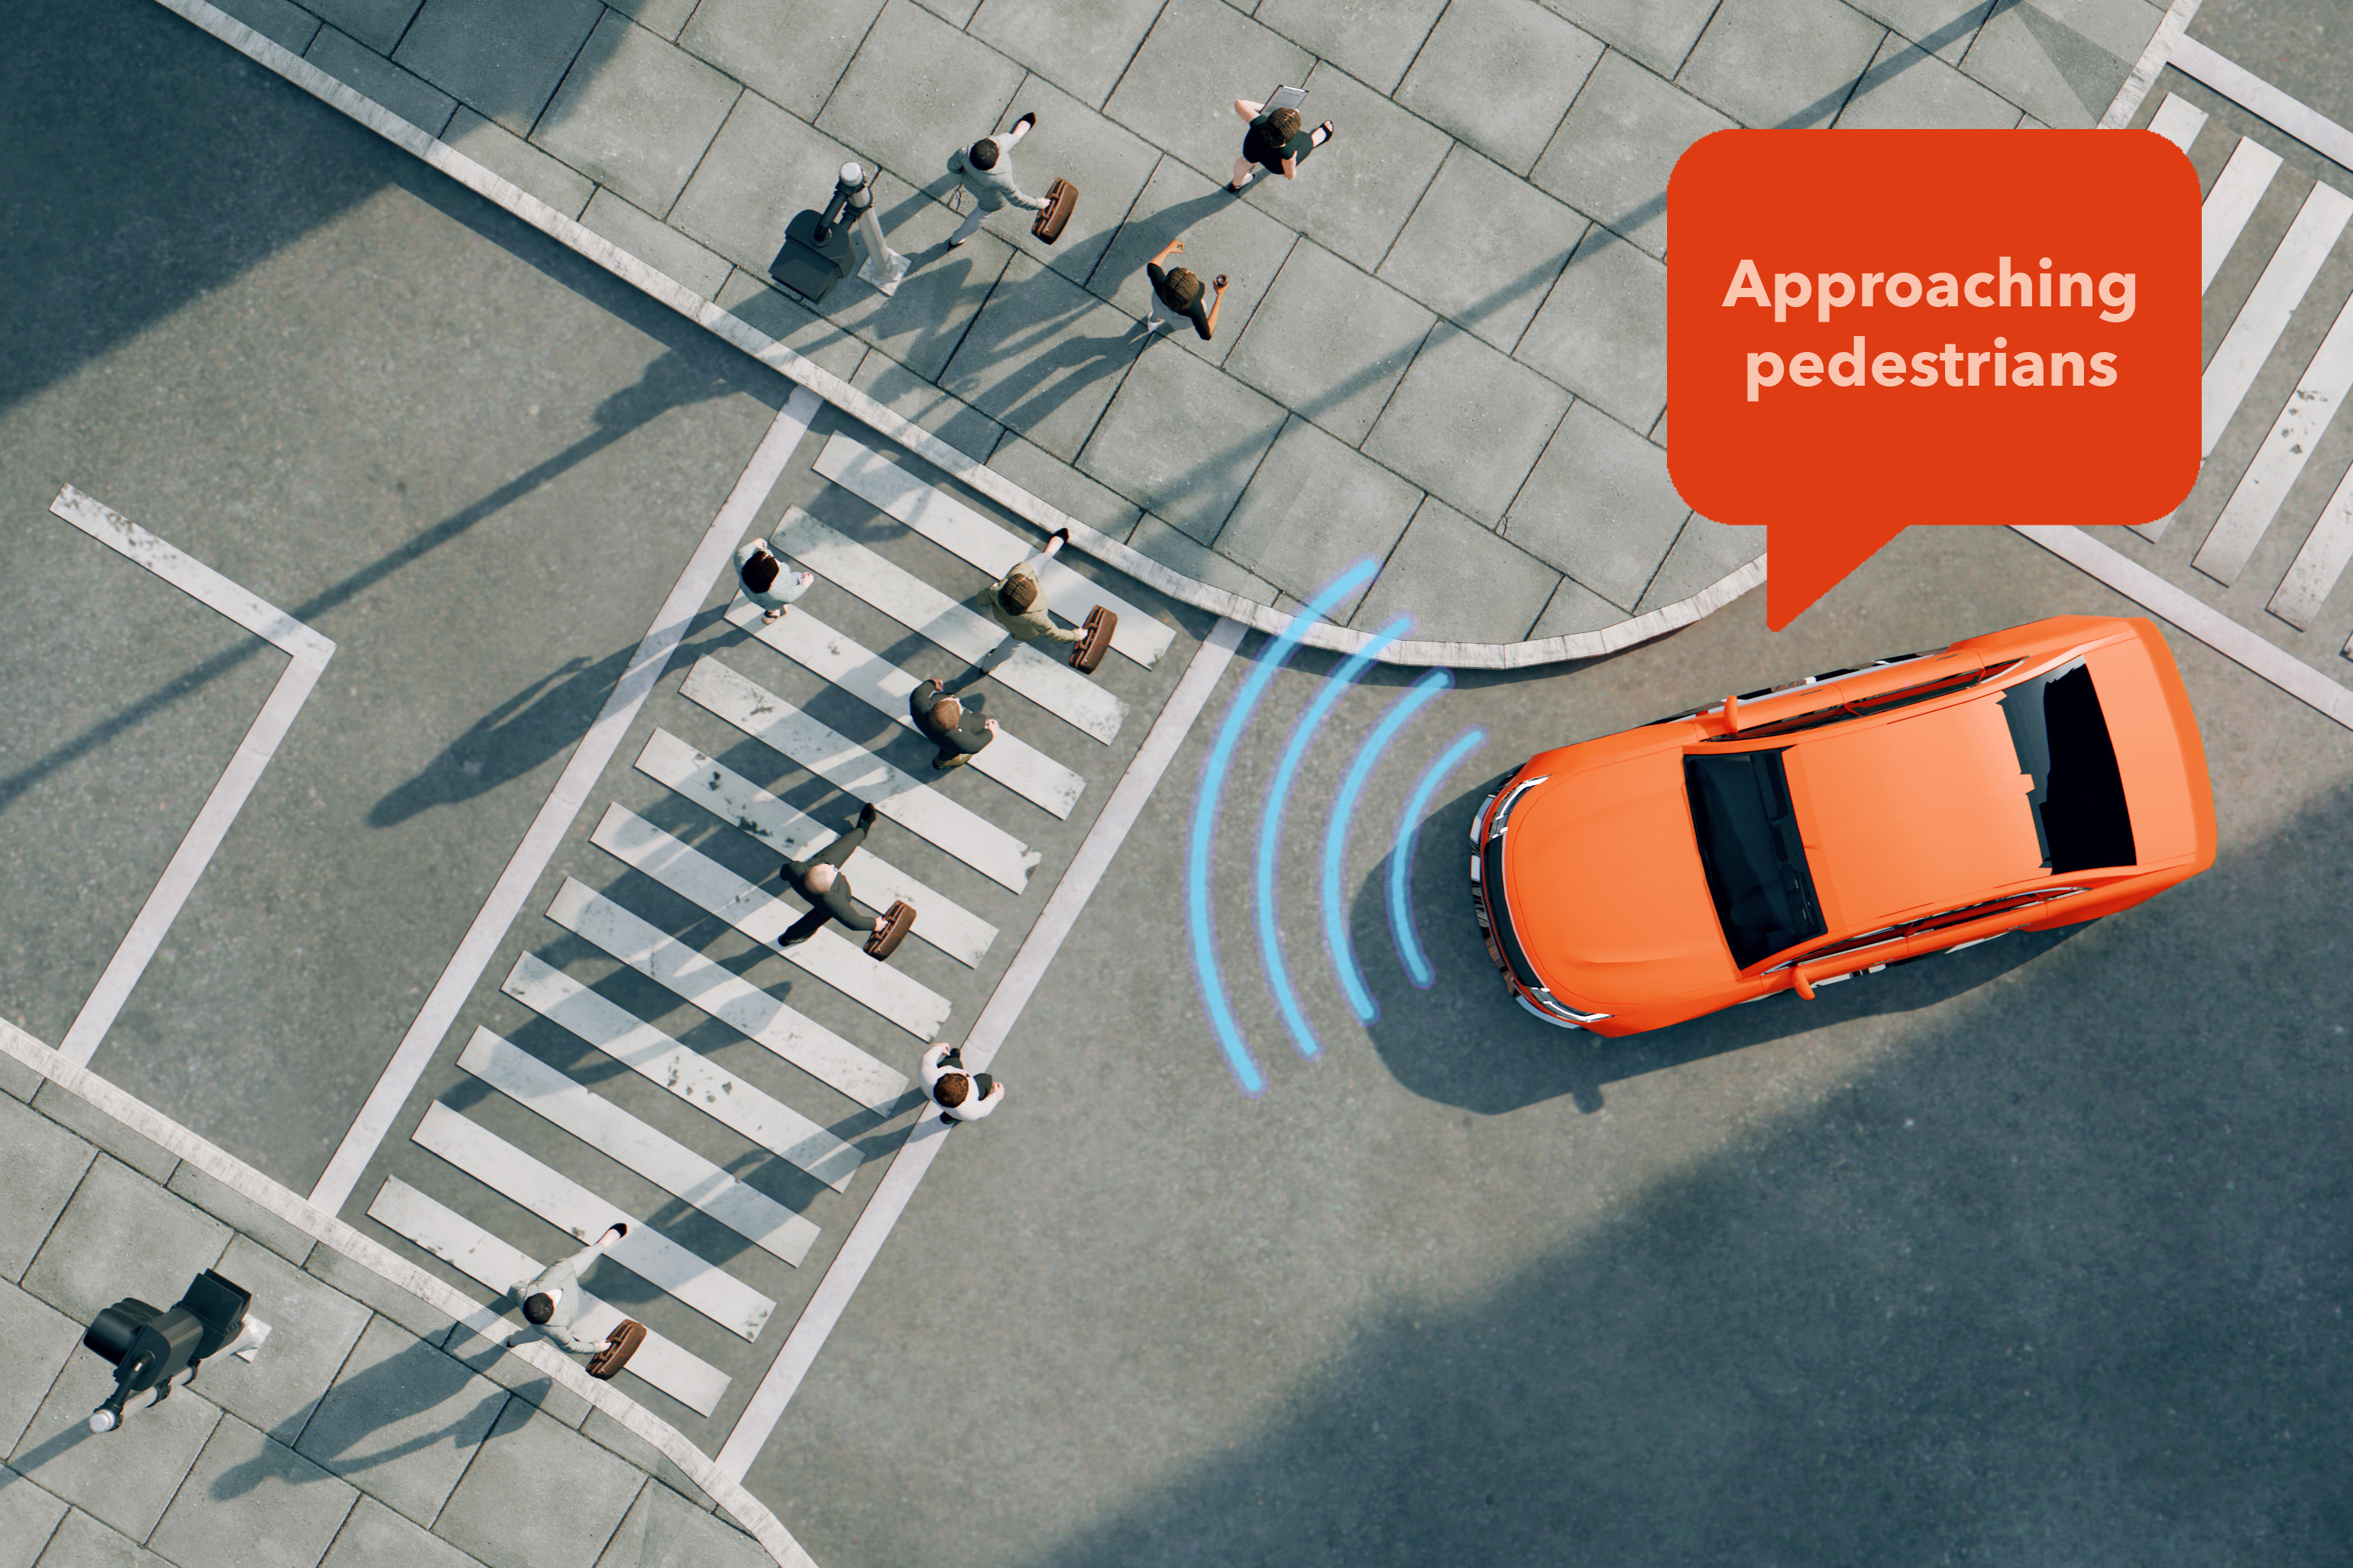
ÖzetSummaryMIT ve Motional'ın ortak geliştirdiği CW-Net adlı kavram sınıflandırıcı modülü, otonom araç planlayıcılarına entegre edilerek opak derin öğrenme kararlarını sürüş performansını düşürmeden gerçek zamanlı ve insan tarafından okunabilir kavramlara (örneğin 'bisikletçiye yakın') dönüştürüyor.The CW-Net concept classifier module, jointly developed by MIT and Motional, integrates into autonomous vehicle planners to translate opaque deep learning decisions into real-time, human-readable concepts (e.g., 'close to a cyclist') without degrading driving performance. |
Neden ÖnemliWhy it mattersOtonom araçlar ortak trafiğe girerken, kara kutu niteliğindeki planlayıcıları güvenlik sürücülerini, yolcuları ve mühendisleri hâlâ karanlıkta bırakıyor. Araç neden fren yaptı ya da şerit değiştirdi, kimse bilmiyor. Güvenilir ve gerçek zamanlı bir açıklama katmanı, insan-makine güven boşluğunu kapatıp mühendislere devreye alma sürecinde kullanılabilecek geri bildirimler sunabilir. Otonom araçların güvenli biçimde yaygınlaşabilmesi için bu iki koşul da ön koşuldur.As autonomous vehicles enter shared traffic, their black-box planners still leave safety drivers, passengers, and engineers in the dark. No one knows why the vehicle braked or changed lanes. A reliable, real-time explanation layer can bridge the human-machine trust gap and provide engineers with actionable feedback during the deployment process. Both conditions are prerequisites for the safe widespread adoption of autonomous vehicles. |
Öne ÇıkanlarHighlights
|
EleştiriCritical takeDeğerlendirme yalnızca özel bir pist ve bir simülasyonla sınırlı. Açık yolda, karmaşık trafikte ya da düşmanca koşullarda yapılan testlere dair bir rapor yok. Bu da açıklamaların gerçek dünyadaki sağlamlığını kanıtlamıyor. 'Nedensel sadakat' garantisi, 130 milyon örneklik etiket setinin sağlamlığıyla sınırlı. Kavramların sistematik biçimde yanlış etiketlenmesi, kendinden emin ama yanlış açıklamalar üretebilir. Makale bu arıza modunu yeterince test etmiyor.The evaluation is limited to a private track and a simulation. There are no reports of testing in open roads, complex traffic, or adversarial conditions, which fails to prove the robustness of the explanations in the real world. The guarantee of 'causal fidelity' is limited by the robustness of the 130-million-sample labeled dataset. Systematic mislabeling of concepts could produce confident but incorrect explanations. The article does not sufficiently test this failure mode. |