 Tencent, Hy4 adlı yeni açık ağırlıklı büyük dil modelini tanıttıTencent introduces Hy4, a new open-weight large language modelHabere gitRead the article Türkçe (otomatik çeviri) English (automatic translation) |
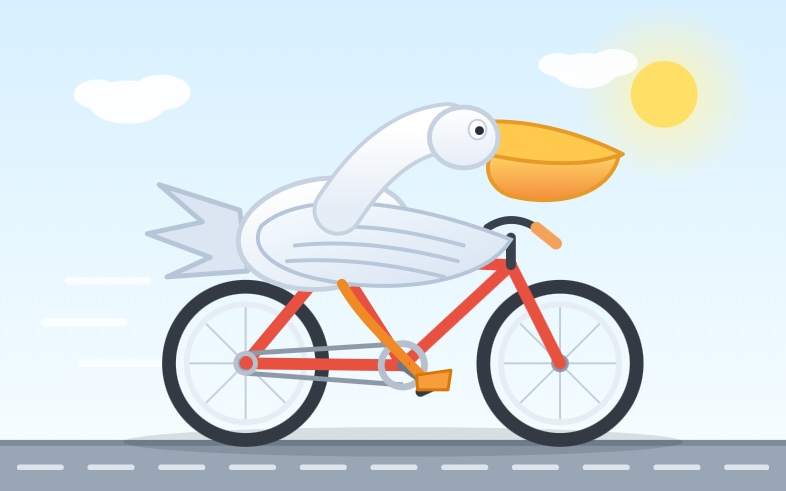
ÖzetSummaryTencent, 770 milyar toplam (49 milyar etkin) parametreye ve 1 milyon tokenluk bağlam penceresine sahip, yalnızca metin işleyen açık ağırlıklı büyük dil modeli (LLM) Hy4 Preview'yi yayınladı. Model, Temmuz ayında çıkan Hy3 öncülüne kıyasla yaklaşık 2,6 kat daha büyük. Simon Willison, modelin sohbet şablonunu inceledi ve OpenRouter üzerinden hızlı bir SVG oluşturma testi gerçekleştirdi.Tencent released Hy4 Preview, an open-weight large language model (LLM) that processes text only, featuring 770 billion total parameters (49 billion active) and a 1 million token context window. The model is approximately 2.6 times larger than its predecessor, Hy3, released in July. Simon Willison examined the model's chat template and conducted a quick SVG generation test via OpenRouter. |
Neden ÖnemliWhy it mattersBüyük bir Çinli laboratuvardan gelen 1,56 TB'lık açık ağırlıklı model, sınır kapalı modellerle arasındaki farkı daraltıyor ve araştırmacılara ile kendi sunucularında barındıranlara gerçekten büyük bir MoE seçeneği sunuyor. Bağlam penceresinin 256K'dan 1M'e, etkin parametre sayısının ise 21B'den 49B'ye yükselmesi, açık Çinli laboratuvarların sunabileceği kapasitede anlamlı bir ilerleme olarak görülüyor. 'high / no_think' ikili akıl yürütme anahtarı, kullanıcıların hesaplama gücünü ne kadar düşürebileceğini kısıtladığı için dikkatle izlenmesi gereken bir tasarım tercihi.The 1.56 TB open-weight model from a major Chinese lab narrows the gap with closed-source models and offers researchers and self-hosters a genuinely large MoE option. The increase in context window from 256K to 1M and active parameters from 21B to 49B is seen as a significant step forward in the capacity that open Chinese labs can provide. The 'high / no_think' binary reasoning switch is a design choice that warrants careful scrutiny, as it limits how much users can reduce computational power. |
Öne ÇıkanlarHighlights
|
EleştiriCritical takeMakale, temelde tek bir anekdotal istem testinden ibaret bir bağlantı paylaşımı; kıyaslama verisi, görsel işleme yeteneği, gecikme veya maliyet bilgisi bulunmuyor. Bu nedenle 'büyük boyut artışı' iddiası, kanıtlanmış kalite kazanımlarına değil, tamamen parametre sayılarına dayanıyor. İkili akıl yürütme anahtarı da 'high' modunun kullanıcı derinlik kontrolü olmadan 'her zaman çok düşün' anlamına gelip gelmediği sorusunu akla getiriyor; bu durum, rutin görevlerde kaynak israfına yol açabilir.The article is essentially a link share based on a single anecdotal prompt test; it lacks benchmark data, visual processing capabilities, latency, or cost information. Consequently, the claim of 'large size increase' relies entirely on parameter counts rather than proven quality gains. The binary reasoning switch also raises the question of whether 'high' mode means 'always think deeply' without user control over depth, which could lead to resource waste on routine tasks. |